Výše znázorněný diagram z dostupných blokových schémat čipu Tahiti asi nejvěrněji zachycuje strukturu čipu, přesto některé části (přinejmenším bloková L2 cache) neodpovídají realitě, ale k tomu se dostaneme v následující kapitole. Základní jednotkou unifikovaného jádra je CU (Compute Unit) označená ve schématu jako GCN. Čip Tahiti těchto bloků nese 32. Podívejme se na jeden podrobně:

Texturovací jednotky se staly součástí výpočetního bloku (podíváme se na ně v samostatné kapitole) a každý nese 4. O řízení chodu CU se stará scheduler, branch unit a skalární výpočetní jednotka, která se může sama podílet na dalším větvení kódu. AMD výkon skalárních jednotek do celkového výpočetního výkonu nezahrnuje.
Hlavní výpočetní silou jsou čtyři SIMD vektorové jednotky. Jde o tradiční SIMD (single instruction - multiple data) architekturu ve smyslu skupiny aritmeticko-logických jednotek, která je schopna provést na (šestnácti) datových prvcích jednu operaci. Tím se architektura zásadně liší od dosavadních VLIW architektur (ať už od koncepčně superskalárních R600-Cayman nebo vec3+scalar co-issue/dual issue architektury R300-R580). V tomto směru jde pro AMD (ATI) o největší změnu za posledních deset let, neboť opouští směr nastavený čipem R300 (Radeon 9700), který byl po léta vyvíjen a rozšiřován.

Dosavadní jednotky - ať už v rámci superskalárního 4D / 5D bloku nebo jako vec4 + skalár u starých DX9 čipů - prováděly každá odlišnou operaci. Například v případě čipu Barts, kde jsou jednotky uskupeny v superskalární 5D skupině, mohla každá z pětice jednotek zároveň realizovat jinou operaci. Vedlejší pětice jednotek ale prováděla tytéž operace, jako její sousedka a stejně tak všechny v celém SIMD bloku (kde bylo „pětic“ celkem 16).
Takový systém byl velice vhodný pro grafické operace (předpokládáme, že grafická efektivita VLIW-5 čipů, jakými byly například RV770, RV740 nebo Barts, zůstane navždy nepřekonaná), ale méně se hodil pro výpočetní nasazení, jehož požadavky mohou být mnohem variabilnější. Jako typický příklad bývají uváděny závislé výpočty, kdy výsledek výpočtu A je potřebný pro zahájení výpočtu B. V krajních případech mohlo dojít na situaci, kdy byl z každé pětice využit pouze jeden instrukční slot - zbytek nemohl být obsazen, neboť pro spuštění dalších výpočtů je třeba znát výsledek předešlého. Tím mohlo v nejhorším možném případě dojít k nevyužití 4/5 (tedy 80 %) výpočetní kapacity.

Určité zlepšení přinesla architektura VLIW-4 čipu Cayman, která pro tento extrémní případ snížila poměr nevyužitých jednotek na 3/4 (75 %). Především ale eliminovala pátou jednotku, která měla charakter SFU (special function unit) pro grafické operace, přičemž její speciální funkce nebyly podporované v přesnosti, kterou by vyžadovalo výpočetní nasazení.

Oproti VLIW architekturám provádí GCN jednu operaci na všech 16 jednotkách, vedlejší SIMD může provádět jinou operaci na svých 16 jednotkách a tak dál. Každý SIMD funguje nezávisle a pokud jeden provádí závislé výpočty, nic tím neblokuje, ostatním je to jedno a pracují na něčem jiném. Celé GPU Tahiti tak lze popsat jako dvě sady 64 nezávislých vektorových (vec16) procesorů. Ať už tedy jde o sériový kód, aplikaci optimalizovanou pro VLIW architekturu nebo třeba násobení matic, vše funguje s vysokou efektivitou.
Čip Tahiti a v podstatě i celá architektura GCN nemá žádné výpočetní jednotky ani cache, které by byly určené pouze pro výpočetní (negrafické) operace. Grafické i výpočetní úlohy tedy běží ze 100 % na identickém hardwaru. Často se objevuje otázka, zda přechod k architektuře GCN nepovede ke snížení efektivity v grafických operacích.
Na tuto otázku nebude možné ještě poměrně dlouhou dobu objektivně odpovědět, protože nesrovnáváme jen dvě architektury, ale také různé ovladače a především různě vybavené grafické čipy. Nemůžeme totiž zapomínat, že konkrétně čip Tahiti nese oproti Caymanu prvky, které sice samy o sobě nebude nijak velké, ale dohromady mohou zabrat desítky čtverečních milimetrů křemíku. Jsou to například videoprocesor VCE, komplexnější PCIe 3.0 řadič, podpora pro další audiokanály, podpora DirectX 11.1, odlišné texturovací jednotky a komplexnější podpora technologií pro úsporu energie, které se rovněž podepisují na rozměrech čipu. Se závěry v tomto ohledu bude lepší počkat na některé z menších GPU, které bude počtem tranzistorů bližší stávajícím produktům.
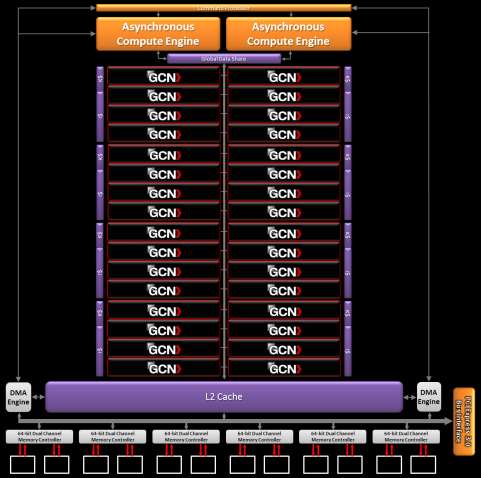
Vraťme se k výpočetnímu nasazení. Kromě nových výpočetních jednotek se výraznou měrou může projevit přínos dalších změn, jakými je univerzální L1 cache a L2 cache o kapacitě 768 KB (to je samozřejmě stále o něco méně, než například u procesorů, na druhé straně má grafický čip k dispozici vlastní paměť s přenosovou rychlostí 264 GB/s oproti procesoru, který je závislý na několika desítkách GB/s, které mu nabízí operační paměť).
O řízení se stará dvojice ACE (asynchronnous compute engine), jejichž úkolem je převzít úlohu, rozdělit a provést prostřednictvím dostupných výpočetních bloků. ACE mohou fungovat nezávisle, umožňují efektivní multi-tasking, rozhodují o alokaci zdrojů, řízení priority a podobně. Přestože je GCN (jak je v případě grafických čipů zvykem) in-order architektura, mohou ACE úpravou priority ovlivnit, v jakém pořadí budou úlohy dokončeny. O efektivní využití přenosové kapacity PCIe 3.0 se stará dvojice DMA jednotek.
Architektura GCN podporuje DP (double precision) nativně. I v případě, že pro DP není konkrétní čip nijak optimalizovaný, jej může emulovat 1/16 SP výkonu. Dále architektura umožňuje podporu DP v 1/2 nebo 1/4 výkonu. Radeon HD 7970 podporuje DP s 1/4 výkonu, což v praxi znamená 947 DP TFLOPS (to je více, než nabízel například Radeon HD 5970 postavený na dvojici čipů Cypress).
Tahiti vůbec jako první GPU kompletně podporuje OpenCL 1.2 a DirectCompute 11.1.
AMD Tech Day, Mnichov (8. prosince)


Copyright © 1998-2026 CDR server s.r.o.
Všechna práva vyhrazena.
ISSN 1804-5405.
Nastavení soukromí